
11月20日,OpenAI发布最新安全公告,宣布进一步加强GPT-6.2 Astra和GPT-6.2 Sol的反蒸馏防护。简单来说,就是防止其他AI通过特殊手段,大规模获取ChatGPT的内部思考过程,再拿这些数据训练自己的模型。
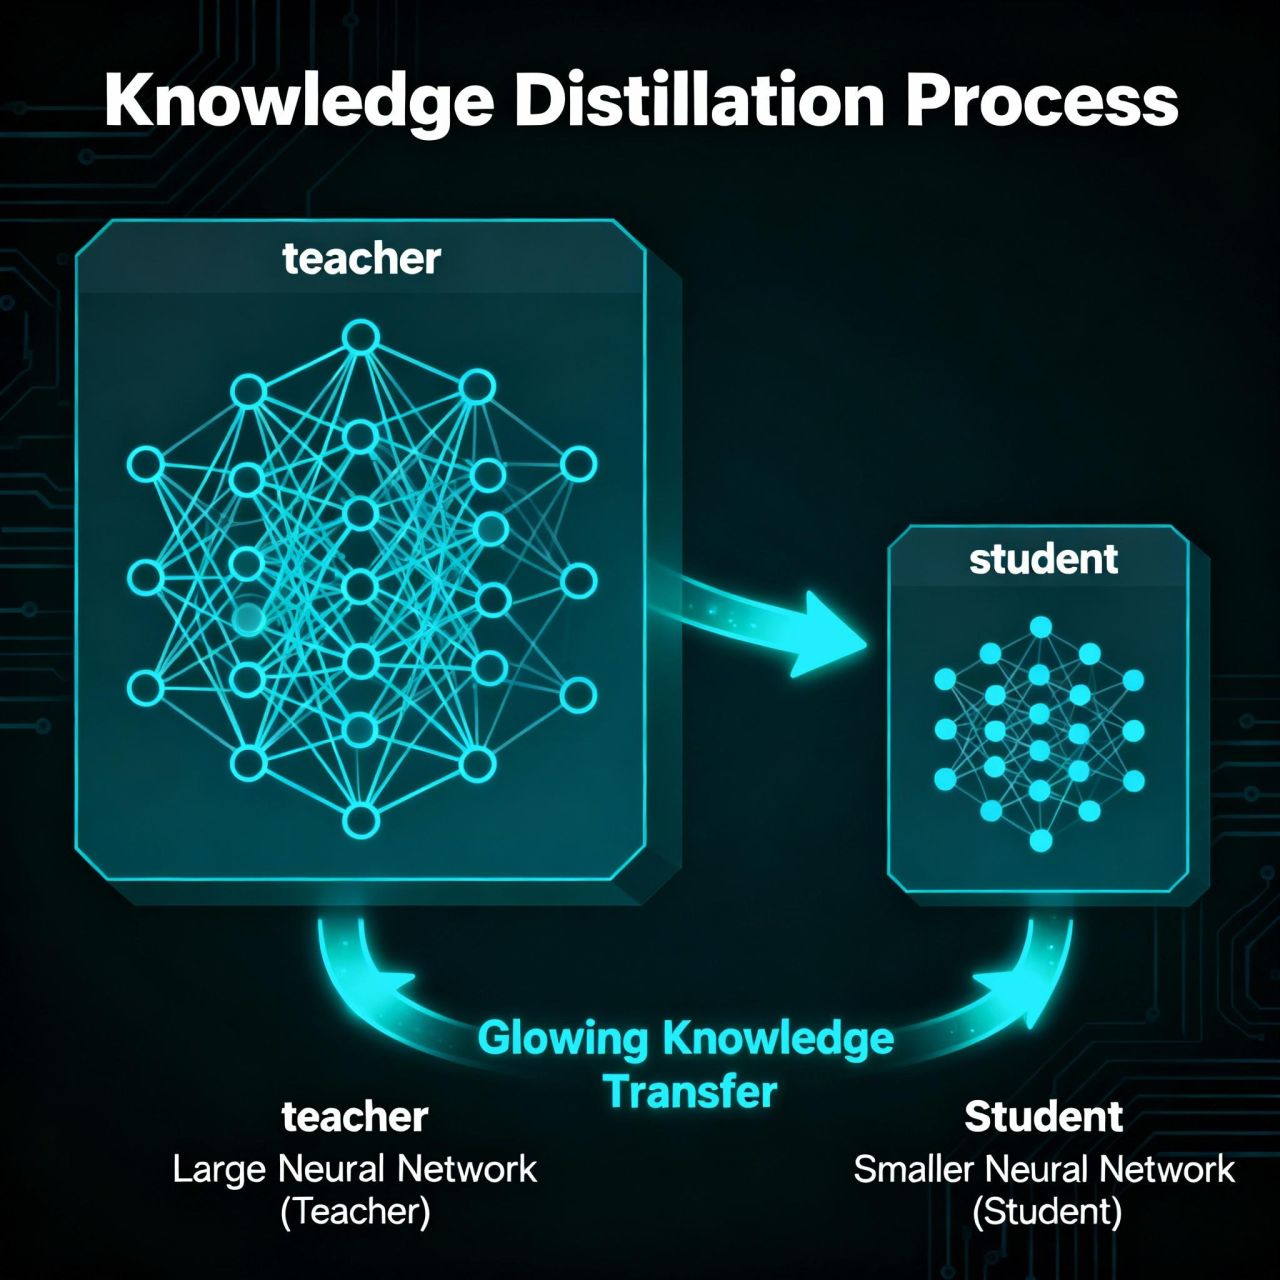
那什么是AI蒸馏呢?其实就是让一个AI充当老师,另一个AI通过学习它的回答、判断甚至推理过程,获得相似的能力。蒸馏本身是常见的技术,但OpenAI担心,未经授权的蒸馏可能让其他模型学到先进能力,却没有继承原模型的安全限制。
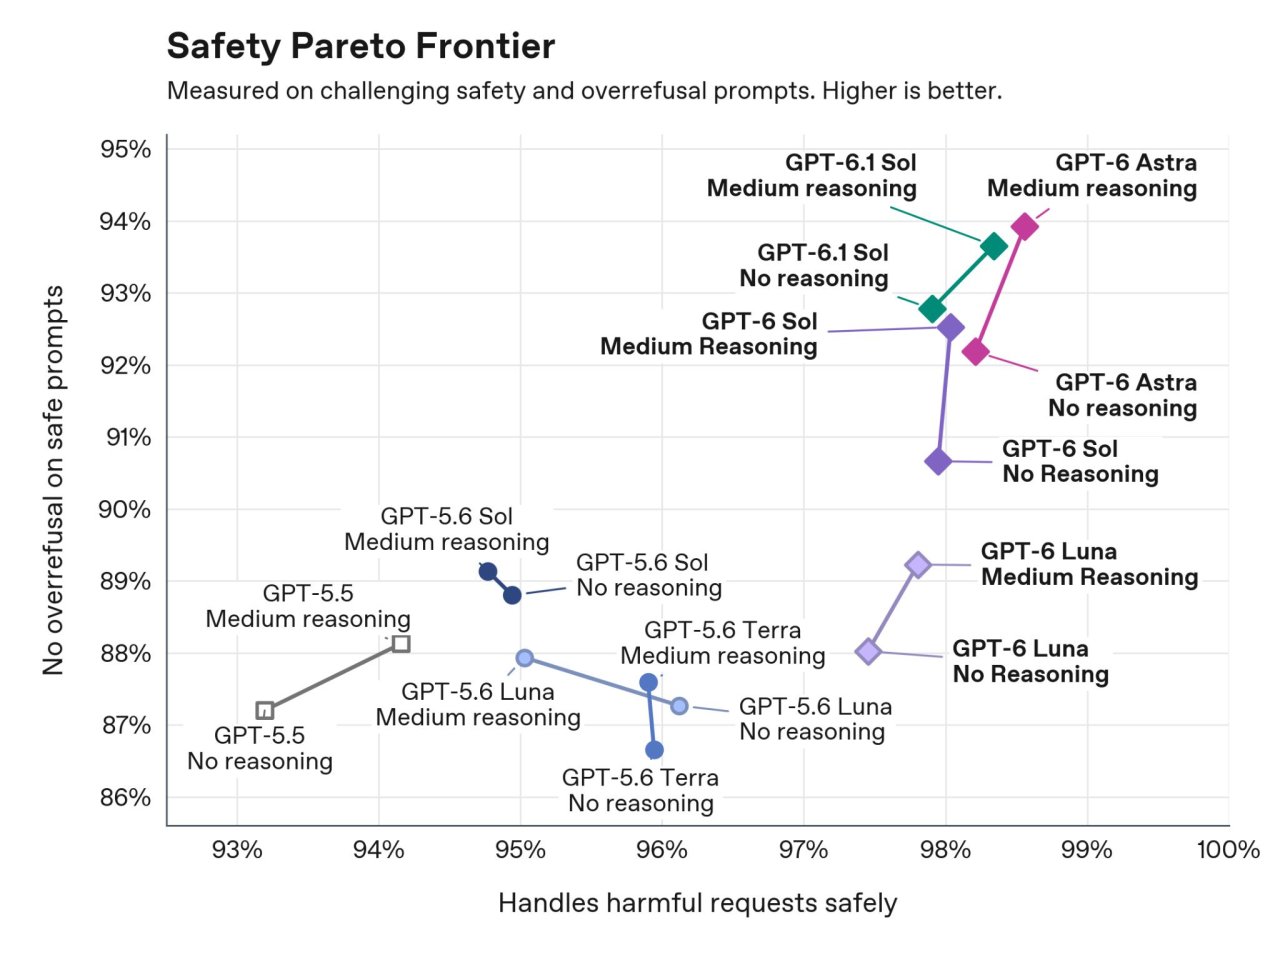
这次OpenAI公布了一组相当夸张的测试数据:在针对之前对话推理内容的提取攻击中,成功率从GPT-6 Astra的54.0%,下降到了GPT-6.2 Astra的0.2%。而针对当前对话推理内容的攻击,成功率也从22.9%降至0.9%。这些数字来自OpenAI使用6个攻击模型进行的内部测试,对比的是不同版本模型及其配套防护措施。
为了防止被蒸馏,OpenAI采用了多重防护机制,包括训练模型识别推理提取攻击、利用分类器检测信息泄露,以及限制推理内容在不同对话和模型之间的复用。新机制还会将受保护的推理内容与原始对话关联,一旦此前的对话内容被修改,后续相关推理内容便不能继续复用。
OpenAI透露,今年以来,公司几乎每周都在针对未经授权的模型蒸馏活动采取账号执法措施,涉及账号规模从数千到数万个不等,而且今年夏季以来明显增加。这说明模型蒸馏的攻防,早已不是实验室里的理论问题。
原文链接:https://www.he6.net/28798.html,转载请注明出处。