
写在前面
自华硕接手英特尔NUC业务后,这条经典产品线可谓一路狂飙,如今已强势迭代至第16代,今年登场的NUC 16 Pro,全系标配了基于最新18A制程工艺的Panther Lake架构处理器。
以顶配版为例,它的核显性能不仅直逼RTX 4050 Laptop,更爆发出最高180 TOPS的异构AI算力,加上极其出色的能耗比,让这套强悍配置被完美浓缩进了0.7L的紧凑机身之中。
今天上手的这台,是搭载Ultra X7 358H的次顶配版本,配备了32GB LPDDR5X 8533 MT/s高频内存和1TB SSD。需要强调的是,它的核心定位其实是能够7×24小时不间断运行的桌面级商用AI智能体,如果单纯拿同价位的传统DIY台式机来比拼性能,其实是一种“错位比较”。
华硕NUC 16 Pro的独特价值,在于它在0.7L的极致形态下,提供了同级别的AI算力与图形性能,以及NUC传统的企业级稳定性和完善的售后保障。
外观和内部结构鉴赏
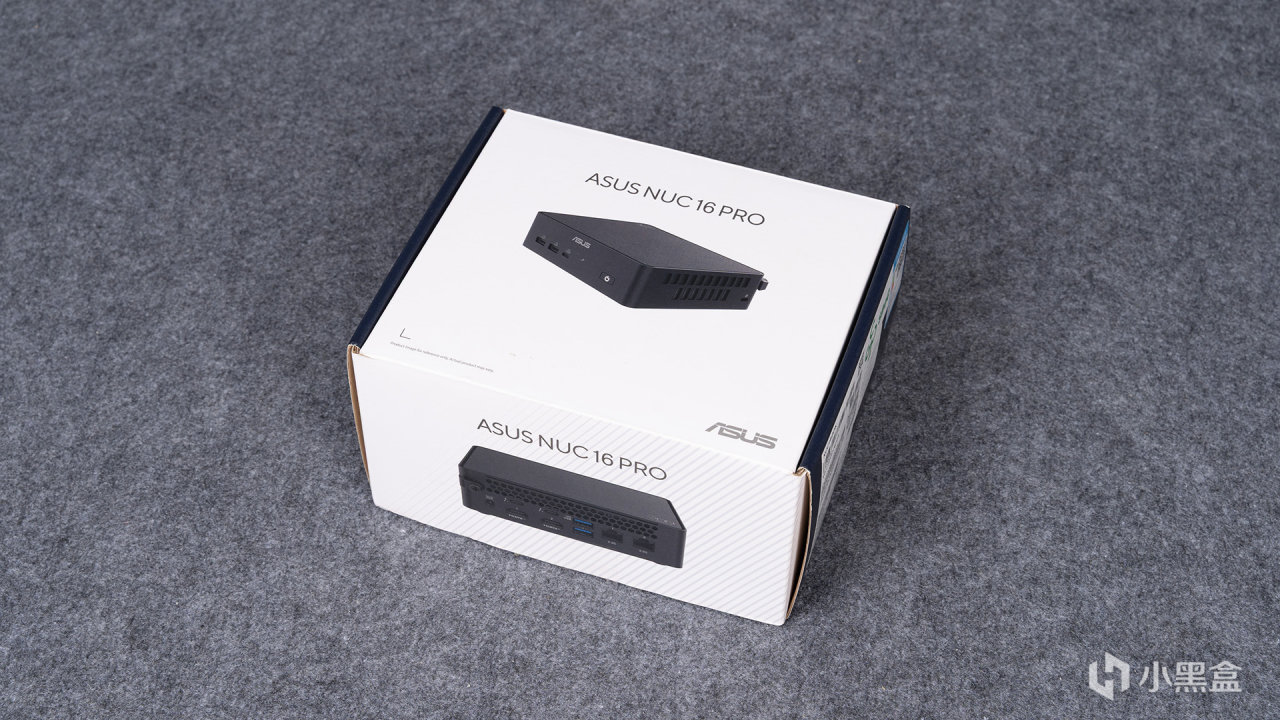
华硕NUC 16 Pro外包装采用极为简洁的黑白双拼色,顶部、侧面都有机器的渲染图和产品名,透着一股极其克制和务实的商务风。
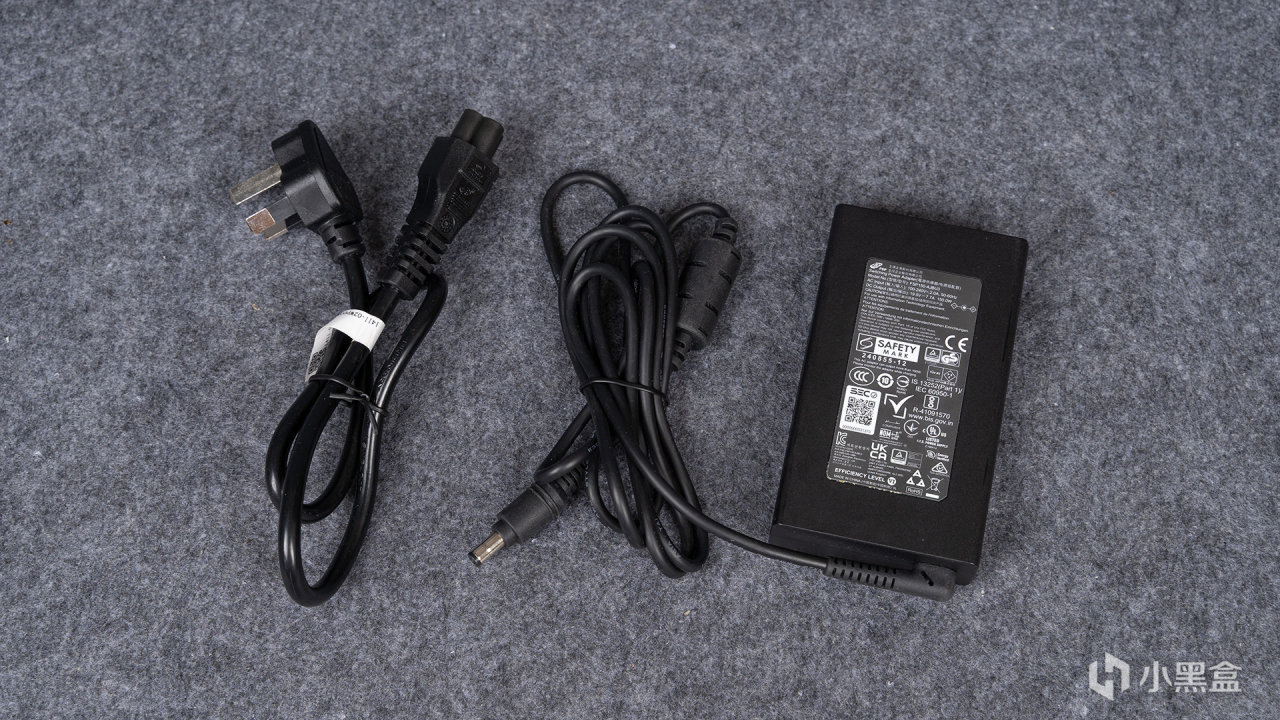
这台机器配备了一块全汉代工的150W电源适配器(19.5V/7.7A),采用分离式插头。也许会有人觉得CPU的cTDP才65W,配150W太夸张,其实这不仅是为了给整体硬件留出充足的峰值冗余,更是为了支撑I/O接口的PD供电需求。
另一方面,个人是非常赞同这种外置电源的设计,首先是让0.7L的机身省去了电源的发热,腾出宝贵的散热空间,其次也是为了方便全球用户适应不同的电源线。
配件方面还附带了VESA背板和螺丝包——挂载在显示器背后即可实现零桌面占用,这在商用场景中属于常规操作,部署也极其简单,对准滑轨一扣即可锁定。
华硕NUC 16 Pro的形态从正方体演变为了更宽的长方体,主要为了给更庞大的主板和散热模组腾出空间。外观采用纯黑配色,顶部做成了耐看且防滑的粗磨砂工艺,其余区域则是手感极佳的细磨砂工艺,整体质感非常扎实,不过还是容易留下指纹。
三围尺寸上,华硕NUC 16 Pro是14.4X11.7X4.2 CM,折算下来也就是0.7L左右,数值可能不够直观,大家参考上图的Ultra 7 270K Plus包装盒就能有个概念。
有意思的是,这代体积和上一代居然惊人的一致,它不是单纯变大变小,而是把高度压扁、长宽拉伸,在同样的体积下,塞进了更强大的主板和散热结构。
前置面板提供了2组USB 3.2 10G与1组Type-C 10G(支持15W PD供电),方便接驳高频使用的外设,长条形电源开关齐平于机身右侧,顶部正中央点缀ASUS的LOGO。
华硕NUC 16 Pro在边缘处做了明显的倒角处理,线条更有层次感且不硌手,这属于工业设计的基本操作了。
机身右侧是大面积散热栅格,边缘部分提供了肯辛通锁孔,对于商用设备而言,这种物理防盗设计对资产保全还是非常有必要的,NUC这体积实在太小了,不锁真保不齐会被顺手牵羊。
左侧则延续了对称的散热格栅,下方采用全开放式孔位,主要是为了配合底部的涡轮风扇高效排热,具体结构稍后拆解便知。
背部面板则采用了蜂窝式散热孔,既保证了金属背板在大量开孔后的刚性,又提供了极高的进气效率。
接口排布上,从左到右依次为:线缆固定臂、DC IN电源孔、2个满血雷电4接口(支持DP 2.1视频输出与PD反向供电)、2个HDMI 2.1 TMDS接口(该版本也可按需选配为双DP 2.1)以及2个USB 3.2 Gen2接口。
最引人注目的是,这一代NUC直接给到了两组 2.5Gb LAN网口,这对需要内外网同时连通商用场景来说极其受用。配合丰富的视频接口,整机最高可支持四屏 4K 输出,多任务扩展需求不在话下。
底部的中间区域也布满大面积蜂巢式散热孔,四角区域有垫高硅胶垫,保证进风量同时也防滑。贴有Intel Core Ultra X7、Intel ARC和Windows贴纸(还怪调皮的,反着贴),侧面则是关于机器产品信息的标签。
华硕NUC 16 Pro为了高度适配机器的商用场景,这一代升级成更为易用的快拆结构——单手提拉卡扣即可开启底部盖子。
底盖采用了弹簧卡扣+铰链的开合设计,不扯线且耐用,对于企业日常维护和硬件升级来说是极其友好的。
华硕NUC 16 Pro采用了“夹汉堡”式的双涡轮扇散热:上层是带三根热管双向排气风扇,下层则是内存风扇(上图所看到的),对应SSD部分有一体散热片+大面积导热垫覆盖。
虽然这台次顶配机器是采用LPDDR5X板载内存(无SODIMM插槽),但这组下置风扇并非多此一举,而是专门用来辅助主板、供电模块等其他部件散热的。
华硕NUC 16 Pro机身两侧均排布了散热鳍片阵列,在靠近内存风扇的一端,还采用了复合式设计,顶部和底部各增加了一对鳍片。
总的来说不仅比上一代用料更足,也让整机的立体风道更加完善,另外有个小细节,原本属于 SODIMM插槽的位置,被替换成了硅胶柱体,刚好能起到支撑和缓震的作用。
华硕的主板研发底蕴在这台机器上体现得淋漓尽致,其内部布局规整、堆料扎实,顺利通过了 7×24 小时不间断运行、防跌落、高温高湿等一系列严苛的可靠性测试,考虑到商用场景的多样性,官方还开放了单主板定制方案,让企业能灵活定制不同用途的机器和机箱。
扩展性方面,主板直接配备了双M.2 2280插槽(支持PCIe 5.0 x4与PCIe 4.0 x4),配备免工具旋钮卡扣,人性化到位。
机器原配的SSD是来自镁光2500 1TB,这是为OEM市场专供的PCIe 4.0X4产品,采用232层3D QLC NAND,能达到7000 MB/s+读取速度,日常办公和创作完全可以满足了。
考虑到本次测试需要安装大量模型和测试软件,硬核也使用了一块三星9100 PRO 2TB SSD进行扩展,顺便验证一下它在华硕NUC 16 Pro上的PCIe 5.0满血性能表现。
此外,为了满足深度的工业控制与企业嵌入式需求,华硕还提供了准系统与单主板方案。在这些方案中,主板预留了COM串口、USB扩展针脚、PCIeX1排线等接口,专为工控设备连接和二次开发准备,这正是它作为企业级设备的底层价值体现。
无线网卡被错开安置在PCIe 4.0X4插槽的下方,具体型号为Intel BE200NGW,作为支持Wi-Fi 7的旗舰网卡,它的理论最高速率可达5.8 Gbps,并集成了蓝牙6.0,采用2×2天线与320MHz频宽,足以应对极高吞吐的无线传输需求。
散热、理论和游戏性能实测
本次搭载的Core Ultra X7 358H基于Panther Lake架构打造,采用全新的P+E+LP多核心设计,最高睿频4.8GHz,它带来了180 TOPS的整体AI算力(第五代NPU占50 TOPS),并集成了规模大增的Arc B390核显(12个Xe核心,2.5GHz频率),配合32GB LPDDR5X 8533 MT/s高频内存的共享显存支撑,实际性能堪比中端独显,这回总该能彻底摘掉“亮机卡”的帽子了吧? 纸面参数如此豪华,下面硬核就来深入挖掘一下它的实际表现。
Cinebench R23理论测试,Core Ultra X7 358H多核得分21013 pts,单核得分则是2096 pts,多核方面几乎持平于上一代的Core Ultra 7 255H,其实X7 358H的P核数量是减少的,说明全新E核与LP核IPC是有了质的飞跃,而单核方面则是相当拔尖,能和上一代Core Ultra 9 285H扳手腕了。
功耗释放和散热方面,这里直接上Cinebench R23多核循环15分钟验证,P核稳定4.5GHz,E核与LP核则是维持在3.3GHz、3.2GHz,整体CPU封装功耗63W左右,和cTDP接近,CPU封装温度则是93℃,满载时噪声维持在可接受的范围内。
实际体感如何?硬核在满载时用热成像仪扫了一圈:热量最高处(56℃)集中在左侧的散热格栅排风口,而机身外壳最高只有42℃,手摸上去仅仅是温热,在0.7L的极限空间里能做到如此表现,只能说散热堆料功不可没。
15分钟的Cinebench R23多核循环测试结束后,Core Ultra X7 358H多核最终得分为20807 pts,相比单轮测试仅差距0.9%,属于几乎忽略不计的程度,CPU性能发挥很稳定了。
3DMark Fire Strike显卡分数为18057,CPU分数为29174,Arc B390核显性能确实是大飞跃,这个成绩意味着它已经彻底告别了以往核显“只能亮机”的尴尬,完全跨入了中端游戏独显的阵营。
3DMark Time Spy显卡分数为7084,CPU分数为14760,事实证明了它的DX12性能已经极度逼近RTX 4050 Laptop,在一些游戏中还能用XeSS 3技术实现大反超。
AIDA64内存和缓存测试显示,读取达到112.72 GB/s、写入达到117.66 GB/s、复制达到114.14 GB/s,延迟为91.2 ns。依靠新一代平台原生支持LPDDR5X 8533 MT/s超高频内存,带宽提升极其显著——一方面充分保障了核显的性能释放,另一方面对本地跑AI也极为有利。
7-Zip测试中,压缩评分为114.025 GIPS,解压评分为95.778 GIPS,相比上代Core Ultra 7 255H提升约20%~30%。超高频内存与能效核的协同功不可没。别小看这部分的提升,在商用场景下,日常解压和打包大体积素材,这种肉眼可见的“秒开”速度,体感提升极其明显。
通过CrystalDiskMark跑分对比可以看到,镁光2500 1TB与三星9100 PRO 2TB在顺序读写上都能轻松跑满各自的PCIe上限,在4K随机读取方面两者打成平手均达到711K IOPS,而在4K随机写入上,三星9100 PRO凭借旗舰级的定位以642K IOPS大幅领先。不过作为出厂原配的镁光2500 1TB,在AI商用场景下其实已经很够用了,只有到了视频剪辑这种高强度小文件写入才会有差异。
《Counter-Strike 2》1080P预设低画质,基准测试平均帧率达到261fps,1% LOW帧135fps,电竞游戏方面已经达到超高刷新率水平。
《赛博朋克2077》1080P预设超级画质+XeSS质量,基准测试平均帧率达到63fps,1% LOW帧41fps,3A游戏跑起来也很从容。
《鬼武者:剑之道》1080P预设中画质+FSR质量,基准测试平均帧率达到56fps,1% LOW帧43fps,对于新一点的3A游戏略微调整一下画质也可一战。
最近这两天很火的国产3A《影之刃零》硬核也测了,1080P预设高画质+TSR平衡,在第一关的悲泣溪谷光影复杂的场景平均帧率能跑到64fps,1% LOW帧也稳住49fps,完全达到了流畅游玩的标准,Arc B390确实很给力有木有!
Procyon办公生产力总分拿下7013分,对于一台定位商用的小主机而言,这意味着它在应对庞杂的现代企业级办公流时,性能完全是“溢出”的。比如Word的查找(0.103s)与Excel的函数计算(0.198s),依靠单核的瞬间爆发实现毫秒级响应,即便是PPT视频导出(6.071s)这类相对重负载的任务,也能凭借异构多核架构高效完成。
Procyon照片编辑基准分数达到7414分,坦白说成绩是有惊喜的,它不仅追平了硬核桌面端Ultra 5 250KF+DDR5 7200单通平台的跑分,也达到了上代旗舰Ultra 9 285H的同级水平,拿来应对日常图像处理,妥妥是降维打击。
Procyon视频剪辑基准分数为15521,分数不算抢眼。具体来看,1080P导出和CPU混合加速需要1分钟,4K则是需要2分半钟左右,其实应付基础的视频处理和轻度剪辑也就够了,Arc B390的媒体引擎格式支持也是基本看齐RTX 50系的水平。
AIGC性能实测
我们都知道AI本地部署流程较为复杂,对于商用场景来说,第一讲究的就是效率和低学习成本,推荐大家使用Intel官方的“亲儿子”——AI Playground软件,在安装界面就能看到它的一站式体验,选择了AI Playground Studio模式后,它会自动帮你部署好OpenVINO、llama.cpp-GGUF和ComfyUI这三大底层依赖。重点是这个OpenVINO引擎,相比于通用框架,它专为Intel硬件特调,让其算力能更加充分发挥。
首先来看看部署Qwen 3.5-9B-Q4_K_M(热门大模型代表)的表现,使用llama.cpp-GGUF框架(上下文 32768)执行,Arc B390最终输出总Token达到了4.1K,总耗时4分18秒,其中包含了49.5秒的深度思考时间,扣除思考时间后,纯生成速度约为19.6 tokens/s,对于通用框架来说,这算得上是相当给力的成绩。
换用OpenVINO专属的Qwen 3.5-9B-int4-ov模型,性能迎来爆发,虽然INT4牺牲了精度,但配合动态上下文,它输出3.1K的总Token仅需1分53秒,思考时间仅33.8秒,也就是纯生成速度达到了39 tokens/s(一秒20多个字),比通用框架足足快了一倍!只要不是那种需要极深逻辑推演的死磕任务,用它来追求极致响应速度,绝对是最高效的。
OpenVINO下也支持纯NPU负载,对应的是Qwen3-8B-int4-cw-ov模型(最大Token只有4096),NPU天生适合处理会议提取、文档分类等常驻轻负载,极其省电高效。甚至在调度得当的情况下,我们可以让NPU跑轻负载、GPU跑重任务实现“双开”,当然这种玩法极其考验内存容量,32GB内存可能不太够了。
Qwen 3.5-9B-int4-ov模型推理期间,Arc B390核显基本负载趋近100%了,内存占用约21GB左右,冗余空间还是存在的。
接下来是文生图(Image Gen)的测试,HD Image模块调用的是Juggernaut XL模型(底层基于SDXL微调,属于写实风),在OpenVINO下使用Arc B390核显生成一张1024X1024分辨率图片,跑满20步高质量渲染仅需要16秒。
换到到更为主流的ComfyUI后端(Fast模式,4步),同样是16秒左右的耗时,生成的赛博喵在细节上却被OpenVINO版甩开了一大截。同样的时间,OpenVINO能跑完20步,ComfyUI只能跑4步,足以见得OpenVINO 对底层硬件的优化有多狠。
ComfyUI后端(Fast模式,4步)渲染1024×1024图像,硬件资源占用如上图所示
OpenVINO下渲染1024×1024图像(20步)时,核显满载100%,内存占用却仅15.5GB余量充足。相比ComfyUI后端4步的版本,内存甚至还省了约3GB,干活更多、占资源更少,底层的深度优化实力确实强大啊。
如果追求更高质量的图像输出,建议可以试试Pro 3 Image,它是基于百度文心大模型团队的 ERNIE-Image打造,Arc B390核显使用Turbo模式,同样生成1024X1024分辨率图像,8步就得耗时1分26秒,画面质感自然不是一个层次,而且金属纹理和光影都很真实,适合有苛刻需求的图像创作。
最让人意外的是图生视频也很给力,使用Wan2.2-14B-l2V(阿里巴巴通义万相团队开源)大模型,选择了Fast模式和704X384分辨率,3秒视频最终耗时仅需要4分54秒,在整个渲染过程中,得益于 出色的资源调度机制,显存与内存分配非常合理,并没有出现因爆显存导致的崩溃,感觉用这个 0.7L小机器整一整AI短剧,好像也挺有搞头的。
在跑图生视频时,通过任务管理器监控确实发现内存占用达到了顶峰的31.3GB了,而且Arc B390核显也是长时间维持极高负载的状态,在这种令人窒息的工况下,硬是没有崩溃,确实给力!
LM Studio接入WorkBuddy本地Agent工作流实测
懂代码的可以直接用Python脚本调底层模型接入WorkBuddy,但为了商用场景的高效低门槛,个人觉得套个壳(LM Studio + WorkBuddy)会更方便,不过无论哪种,这种“全本地闭环”的玩法自由度都极高,不仅免了Token计费,想怎么折腾复杂的Agent工作流都可以,而且数据隐私也绝对有保障。这里硬核就使用了Qwen3.5-9B-Q4_K_M进行测试,GPU卸载拉满,上下文长度为40559,其他预设默认。
首先是给它做纯代码生成赛博朋克HTML的活儿,给WorkBuddy装上Filesystem MCP获取读写权限后,吞吐了近3.9万个Token,实测生成速度14.38 tokens/s,耗时8分19秒成功在桌面生成了HTML文件,最终渲染出来的霓虹特效和排版也相当有模有样,这活儿要是个人手写,少说也得几个小时,对于企业来说那就是妥妥的降本增效。
实测在生成HTML时,华硕NUC 16 Pro内存占用约为23.5GB,Arc B390核显负载拉满,后台冗余充足,完全可以边跑边上网摸鱼,此时CPU负载仅有7%,Ultra X7 358H这异构设计分工很明确了。
接下来给它下达进阶的任务——针对刚才生成的HTML网页写一份中文README说明,在 Filesystem MCP的配合下,本地模型消化了高达3.4万Token的上下文,以14.66 tokens/s的速度,仅耗时5分56秒就完美交付了这份“程序员噩梦级别的交接文档”。
而且如果对代码或文档还有任何疑问,你完全可以直接在WorkBuddy里继续追问模型。毫无疑问,华硕NUC 16 Pro这台机器上的本地Agent确实彻底跑通了闭环。
最后,硬核还给它上了一个复合难度的终极大活:
在WorkBuddy里套用“旅游攻略策划专家”的人设,调用bing-search-cn联网搜索,再结合底层的Qwen3.5-9B模型进行规划。在9分39秒的总耗时里,系统后台处理了高达44605个Token的超长上下文(推理前把上下文长度已设置成48743),生成速度稳定在10.59 tokens/s,最终使用Filesystem MCP技能成功生成了完整的HTML文件(交互式思维导图)。
这种多工具无缝串联的能力,证明了整个Agent的闭环工作流体育已经极其丝滑。
总结
总的来说,华硕 NUC 16 Pro并不是一台用来“卷性价比”的常规迷你主机,而是一台重新定义了0.7L 体积上限的商用AI工作站,它凭借18A制程的Ultra X7 358H与32GB LPDDR5X 8533 MT/s超高频内存,交出了直追RTX 4050 Laptop的图形成绩,重点是彻底打通了从AIGC创作到本地智能体(Agent)的全链路闭环。
在这0.7L的极致体积之下,它塞进了“夹汉堡式”双风扇+三热管+大面积鳍片的立体散热模组,能保证硬件长时间最高性能稳定释放,也提供了双2.5G网口与双雷电4这种豪华的商用接口组合——内外网隔离、四屏输出随意折腾。
如果你追求的是桌面级本地AI算力与极简部署,它简直物有所值,但如果只看绝对的DIY硬件成本,那它确实不适合你,毕竟两者的应用场景和诉求完全不在一个维度上,对吧?